Approfondimenti

14 Ottobre 2026

Un milione di elementi conduttori in un minuto, su un laptop con 16 GB di RAM

Una breve storia dei nostri solutori e dei dati pubblicati che supportano questa affermazione: come si comportano i metodi consolidati su questo problema e cosa abbiamo dovuto cambiare, per ben due volte, per arrivare a risolverlo in un minuto.

Un milione di elementi, un minuto.

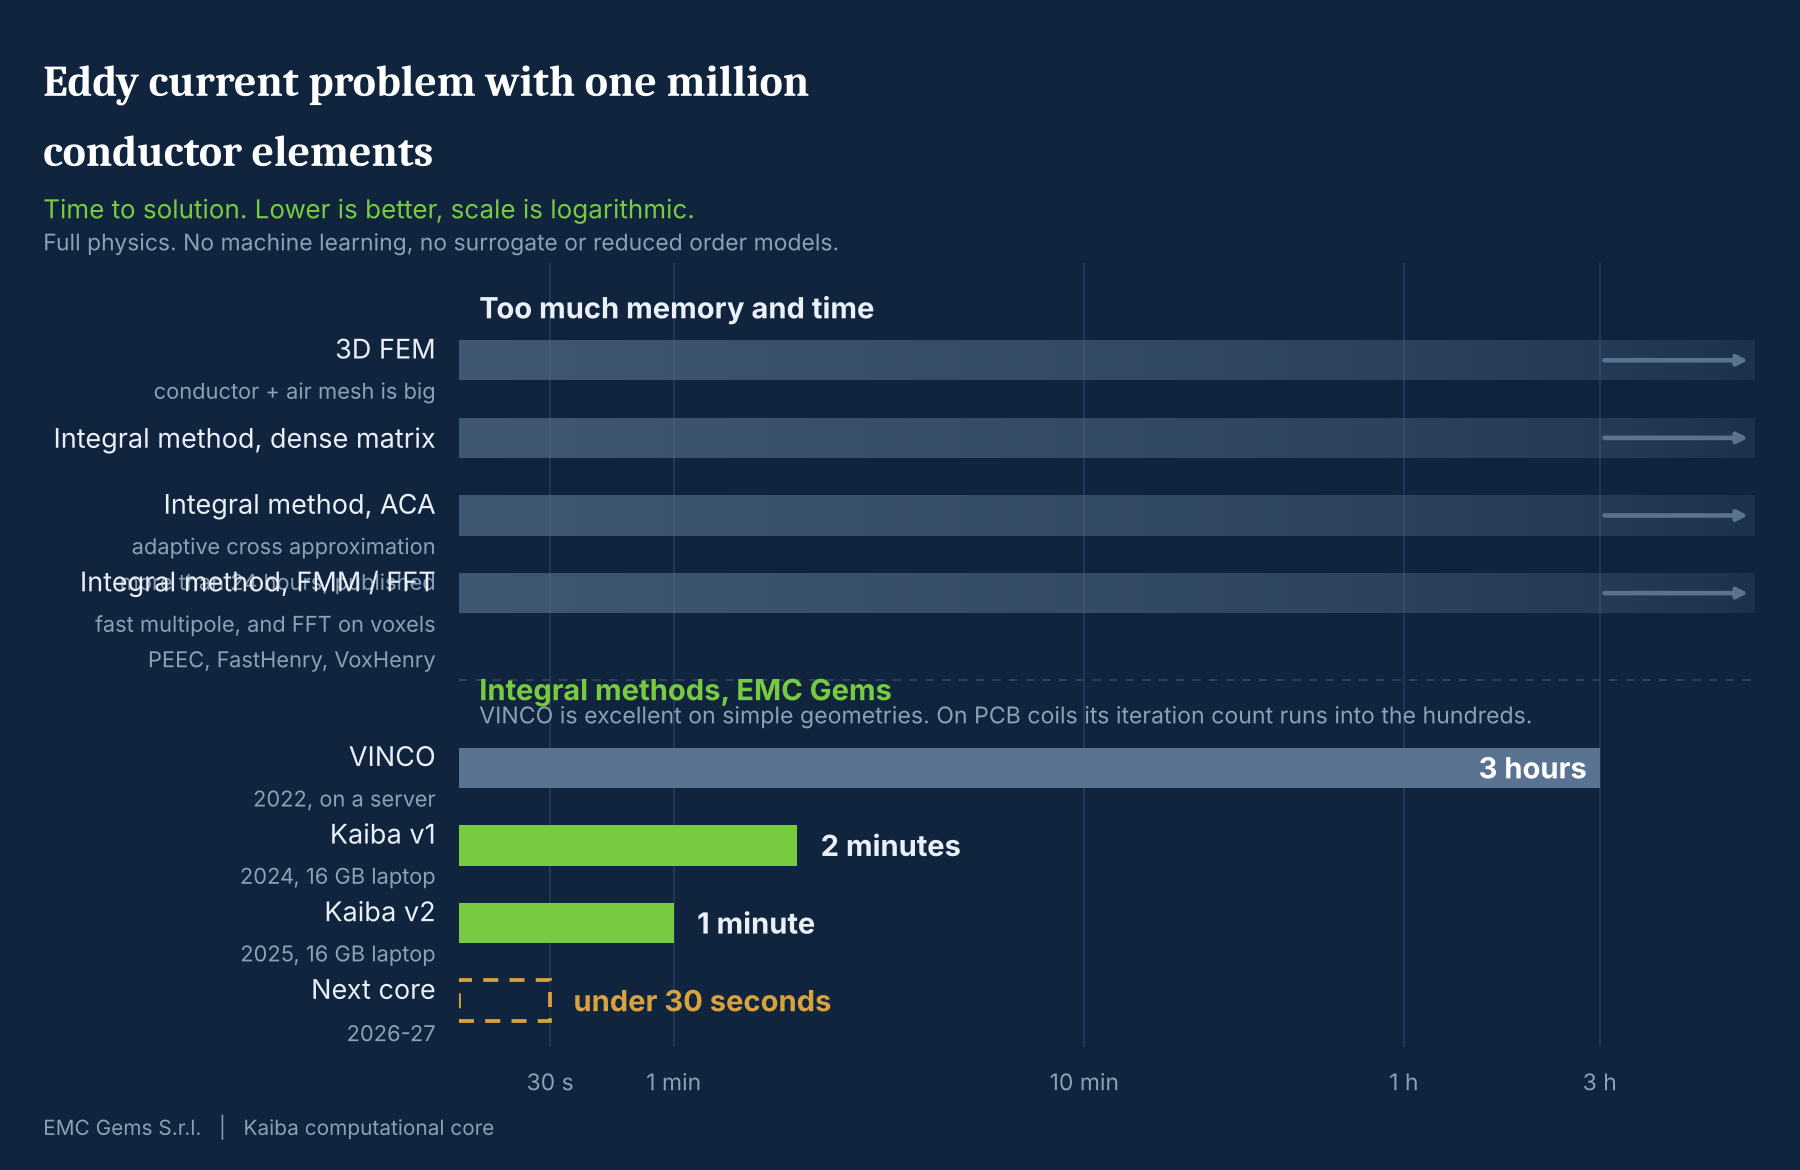
 Abbiamo risolto un problema di correnti parassite (eddy currents) con un milione di elementi conduttori su un laptop con 16 GB di RAM, alla frequenza di 1 MHz, in circa un minuto, utilizzando circa 4 GB di memoria. Un milione di elementi rappresenta esclusivamente il rame: ogni pista e ogni spira di filo. L'aria circostante non viene mai discretizzata, ma il campo elettromagnetico nello spazio circostante può comunque essere ricavato dalla soluzione.

A 1 MHz, la profondità di penetrazione (skin depth) nel rame è di circa 65 micrometri, quasi il doppio dei 35 micrometri di spessore del rame da 1 oz. A questa frequenza, quindi, la corrente sta già iniziando a ridistribuirsi all'interno della sezione trasversale della pista.Il costo computazionale della soluzione non dipende dalla frequenza, nell'intero intervallo in cui è valida l'approssimazione magnetoquasistatica. Al di sopra di tale intervallo è necessario adottare un modello elettromagnetico a onda completa (full-wave): si tratta di un limite del modello fisico, non del solutore.
Elementi finiti

Ho vent'anni di esperienza nella risoluzione di problemi di correnti parassite con il metodo degli elementi finiti, compreso lo sviluppo dei relativi codici di calcolo. 

Non si tratta quindi di una critica al software di altri. Tre aspetti impediscono a questo metodo di affrontare efficacemente problemi di questa classe.

 Discretizzazione dell'aria. 

Anche l'aria deve essere discretizzata. Nel caso di un circuito stampato, un milione di elementi nel rame significa da dieci a venti milioni di elementi nell'aria, spesso anche di più. In molti casi reali, costruire la mesh dell'aria attorno a una bobina multistrato con rame spesso 35 micrometri è semplicemente impossibile.

 Convergenza.

Nell'aria la conducibilità è nulla, quindi scompare il termine che rende non singolare il sistema curl-curl, lasciando un nucleo di gradienti di dimensioni molto elevate. La gravità del problema dipende dalla formulazione e dal precondizionatore utilizzati. Nelle geometrie dominate dall'aria non abbiamo trovato alcuna combinazione, nemmeno con metodi multigrid, capace di convergere in poche iterazioni.

Movimento.

Generalmente il movimento richiede di ricostruire la mesh per ogni posizione, a meno che non presenti una simmetria sfruttabile tramite un'interfaccia scorrevole (sliding interface). Questa soluzione funziona per una macchina rotante, ma non per un target che, oltre a ruotare, si inclina e si sposta.

Metodi integrali e cosa comprende questa definizioneI metodi integrali si suddividono in tre categorie: metodi integrali di volume, metodi integrali di superficie e PEEC (Partial Element Equivalent Circuit). 

Sviluppato utilizzando parallelepipedi con direzioni della corrente fissate a priori. Introducendo funzioni di base analoghe a quelle degli elementi finiti, diventa un metodo integrale di volume. Tutti condividono la proprietà fondamentale per il problema che stiamo affrontando: vengono discretizzati soltanto i conduttori, senza mesh dell'aria né superfici artificiali di troncamento del dominio. Ciò che li distingue è il modo in cui gestiscono la matrice densa che deriva da questa scelta.

Matrici dense

La matrice è piena, quindi la memoria necessaria cresce con il quadrato del numero di incognite. Nel benchmark con un milione di elementi pubblicato nel nostro articolo su CMAME, la formulazione standard con matrice densa richiede 8.141 GB, circa otto terabyte.Non c'è alcun parametro da ottimizzare che possa risolvere il problema. 

ACA – Adaptive Cross Approximation

È la risposta standard proposta in letteratura, ma vale la pena essere espliciti su quanto siano limitati i benefici. Su un modello di 252.000 tetraedri, la compressione ha ridotto il picco di memoria all'8% rispetto al caso con matrice densa, passando da 426 GB a 34,8 GB. Il tempo totale, invece, è sceso soltanto al 43%, da 26.495 a 11.437 secondi. Un miglioramento di un fattore dodici nella memoria, ma soltanto di un fattore due nel tempo, per un problema in cui il divario da colmare è di tre ordini di grandezza. Aumentando la dimensione del problema, questo divario diventa decisivo. Nel benchmark con un milione di elementi, sulla stessa macchina, ACA ha impiegato oltre 24 ore, mentre il metodo descritto più avanti ha richiesto 649 secondi. Inoltre, ACA necessitava di più memoria anche per un problema di dimensioni pari a un quarto. La compressione permette di far entrare questi modelli in memoria. Non è ciò che li rende veloci. 

Fast Multipole Method

Tra le tecniche di compressione pubblicate, è quella che ha ottenuto i risultati migliori nei nostri benchmark. L'obiezione abituale riguarda il numero di iterazioni, ma esiste un secondo problema che quasi mai viene considerato: il costo di una singola interazione. Con le usuali funzioni di base definite sugli elementi, l'interazione tra una coppia di elementi non richiede il calcolo di un solo integrale, ma di un integrale per ogni coppia di funzioni di base. Questo significa 36 integrali di interazione pesati per una base a sei spigoli e 16 per una base di Raviart–Thomas o Rao–Wilton–Glisson associata alle facce. Il framework VINCO utilizza funzioni di base uniformi su ciascun elemento, per cui l'interazione tra due tetraedri richiede un solo integrale. Non si tratta di sacrificare la precisione in cambio della velocità. Nei nostri articoli dimostriamo l'equivalenza delle due formulazioni: la discretizzazione VINCO produce la stessa soluzione discreta e, su una mesh tetraedrica, la sua matrice di rigidezza coincide con quella costruita utilizzando funzioni di base di Raviart–Thomas.Per essere precisi, tale fattore riguarda il costo della parte diretta dell'operatore, ossia le interazioni di campo vicino (near field). L'accelerazione Fast Multipole modifica invece il modo in cui vengono valutate le interazioni di campo lontano (far field).Non elimina la complessità introdotta dalle funzioni di base che variano nello spazio, ma il costo aggiuntivo residuo dipende dall'implementazione. I fattori 16 e 36 vanno quindi interpretati come costi relativi delle interazioni di campo vicino, non come fattori universali applicabili al costo di ogni iterazione.

FFT su voxel

Tra tutti gli approcci descritti, questo è l'unico realmente competitivo in termini di fattibilità computazionale.Il confronto, però, deve essere effettuato a parità di accuratezza. Ed è proprio qui che emergono i problemi. Un milione di voxel non equivale a un milione di tetraedri. Disponiamo di dati relativi a un caso reale: la bobina trasmittente di un sensore induttivo di posizione, con rame spesso 35 micrometri su un circuito stampato da 0,8 mm. Il dispositivo è stato misurato con un Bode100 nell'intervallo da 10 kHz a 10 MHz e simulato con tutti e tre gli approcci. Il metodo FFT richiedeva una griglia computazionale di circa 120 milioni di celle, con risoluzione di 35 micrometri, mentre la formulazione con mesh conforme alla geometria utilizzava circa 800.000 tetraedri conduttori. Il modello tetraedrico mostrava inoltre un accordo migliore con le misure sperimentali, proprio perché rappresentava correttamente le parti curve della geometria. C'è poi un secondo costo nascosto in quella griglia. La FFT opera sull'intero volume computazionale, non soltanto sulle celle contenenti rame. In quell'esempio, 229.000 celle conduttrici erano contenute in una griglia di 120 milioni di celle, con un rapporto tra volume d'aria e volume conduttore pari a 522.Il costo dell'aria rientra così dalla finestra, proprio in una famiglia di metodi nata per evitarlo.

 Non si tratta di una critica costruita per un articolo divulgativo. 

Il nostro articolo su CMAME individua tre limitazioni dell'approccio basato sui voxel:

- La FFT ottiene la propria velocità imponendo una mesh cartesiana.

- La geometria voxelizzata introduce il noto errore a gradini (staircase error), lo stesso che porta generalmente a preferire gli elementi finiti alle differenze finite.

- Una griglia di voxel non consente un raffinamento locale della mesh.La conclusione di quello studio, riportata fedelmente, è che le griglie di voxel accelerate mediante FFT sono adatte a problemi con meno di circa un milione di elementi, senza geometrie curve e con geometrie ben allineate alla griglia strutturata. 

Una bobina su circuito stampato non soddisfa nessuna di queste tre condizioni.

From VINCO to Kaiba

VINCO ha rappresentato un'importante svolta e i suoi risultati sono pubblici.Una sfera piena discretizzata con 1.030.656 tetraedri: 649 secondi su un Threadripper a 32 core con 256 GB di RAM e 1.220 secondi per lo stesso problema su un laptop con 16 GB di RAM, utilizzando un picco di memoria di 13,5 GB.

Il numero di iterazioni rimaneva costantemente tra dieci e venti. Il numero di iterazioni rimaneva costantemente tra dieci e venti.

VINCO è protetto da brevetto insieme all'Università di Udine, con il brevetto statunitense già concesso, e i suoi fondamenti sono stati pubblicati su Computer Methods in Applied Mechanics and Engineering, una delle principali riviste scientifiche nel campo della simulazione ingegneristica.

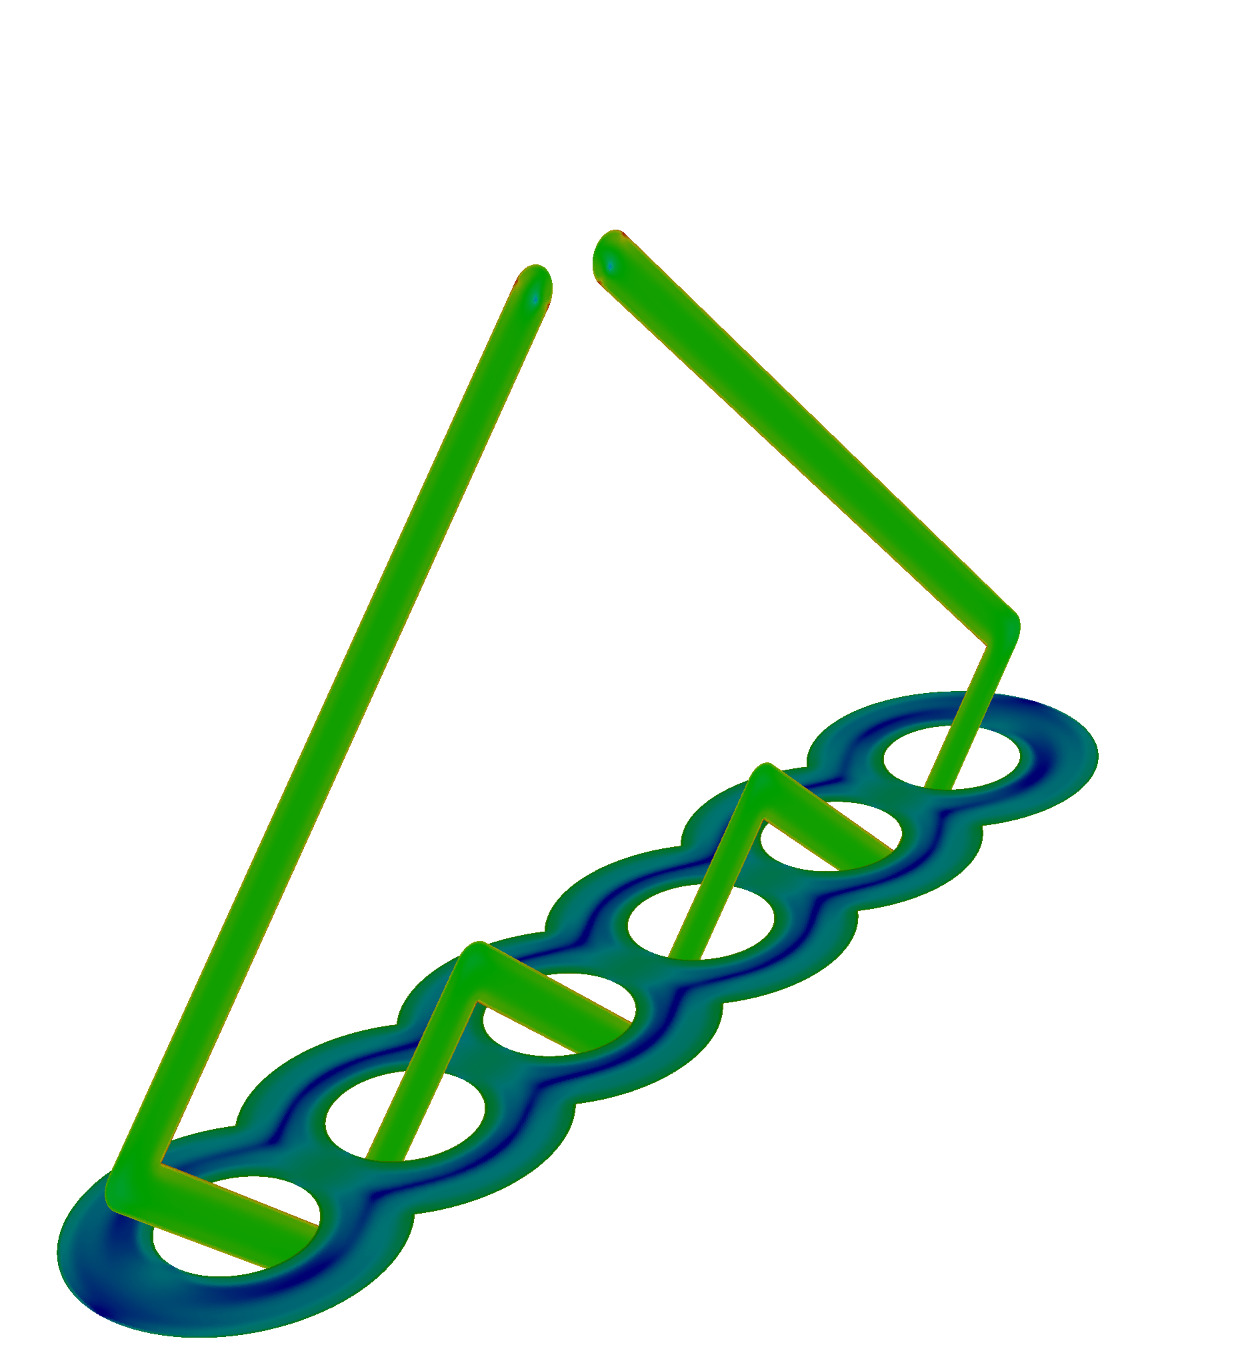
Successivamente, però, le geometrie dei nostri sensori ne hanno messo in evidenza i limiti.I benchmark pubblicati in quegli articoli riguardano una sfera, una piastra forata, una bobina avvolta attorno a un cilindro e una bobina su circuito stampato di otto spire, discretizzata con 514.285 tetraedri e risolta a 5 MHz in 242 secondi.

Quest'ultimo caso è costituito da una singola spirale nello spazio libero e rappresenta il problema più semplice tra quelli che affrontiamo abitualmente.

Aggiungendo un secondo strato, le bobine riceventi intercalate a quella trasmittente e, soprattutto, un target conduttivo posto a pochi decimi di millimetro di distanza, oltre il traferro, il numero di iterazioni sale a diverse centinaia.

La nostra stima per il benchmark di un sensore con un milione di elementi utilizzando VINCO è di circa tre ore.Tre ore sono accettabili se si deve eseguire una sola simulazione.

Le nostre piattaforme, però, eseguono migliaia di simulazioni all'interno di un ciclo automatico di ottimizzazione, perché è così che si progetta realmente un sensore induttivo ad alte prestazioni: si modifica la geometria delle bobine riceventi, si misura l'errore di linearità e si ripete il processo. Con tre ore per simulazione, un ciclo del genere diventa impraticabile.

E un sensore di posizione rappresenta soltanto il punto di partenza rispetto ai problemi che vogliamo affrontare: un convertitore DC-DC con i suoi piani conduttivi e schermi, una macchina elettrica con la geometria reale delle cave, un sistema di trasferimento wireless dell'energia con le strutture metalliche circostanti.

Ciascuno di questi è un modello più grande e complesso, che meriterebbe lo stesso processo di ottimizzazione.

Avremmo potuto dedicare anni a perfezionare VINCO.

Abbiamo invece deciso di tornare alla matematica e ricominciare da capo.

Il risultato è Kaiba, il primo rappresentante di una nuova classe di solutori.

Vale la pena chiarire la portata dei due passaggi, perché un grafico che li rappresenta sullo stesso asse rischia di farli apparire come semplici gradini della stessa scala.

Il passaggio da PEEC a VINCO è un'evoluzione all'interno della stessa famiglia: la stessa equazione integrale, lo stesso tipo di discretizzazione, una migliore fattorizzazione della matrice e un modo più efficiente di applicarla.

Ha portato a un brevetto e a una pubblicazione scientifica, ma rimane in continuità con ciò che esisteva prima.

Il passaggio da VINCO a Kaiba è qualcosa di completamente diverso.

Se misuriamo la distanza in termini di tecnologia anziché di secondi, quella tra PEEC e VINCO è piccola rispetto a quella tra VINCO e Kaiba.Ed è anche l'unica parte del nostro lavoro che non pubblicheremo mai.

Sul benchmark del sensore:- 2024 – Kaiba v1: circa 8 GB di memoria e due minuti.- 2025 – Kaiba v2: circa 4 GB di memoria e un minuto. Entrambi i risultati sono stati ottenuti sullo stesso laptop con 16 GB di RAM.


Perché la vera svolta è la scalabilità

L'obiezione più ragionevole, che preferiamo sollevare noi stessi, è questa: probabilmente uno dei metodi precedenti potrebbe risolvere un problema con un milione di elementi conduttori su una workstation con 64 GB di RAM.È del tutto possibile. Ma non è questo il punto.Il punto è ciò che si può ottenere con lo stesso hardware.

Con circa 4 GB di memoria per milione di elementi, la memoria non rappresenta più il collo di bottiglia immediato.

Abbiamo verificato una scalabilità lineare sia della memoria sia del tempo di calcolo fino a dieci milioni di elementi. Una workstation con 64 GB dovrebbe quindi poter affrontare problemi dell'ordine di quindici milioni di elementi.

Quest'ultimo valore è una breve estrapolazione oltre i dieci milioni verificati sperimentalmente: consideratelo una previsione e giudicateci sui dieci milioni.

A parità di hardware, che si tratti di un laptop, di una workstation o di un nodo di calcolo, questo permette di raggiungere dimensioni di problemi che gli altri approcci non riescono nemmeno ad affrontare. Interi stadi di potenza di inverter con i relativi piani conduttivi e schermi, avvolgimenti completi di motori con la geometria reale delle cave, gruppi sensore completi delle strutture metalliche della macchina circostante. Oggi questi sistemi non vengono simulati perché nessuno strumento disponibile è in grado di fornire una soluzione, non perché manchi l'interesse a farlo.

Esiste anche una conseguenza meno evidente.

Gran parte del lavoro in questo settore consiste nel cercare di far rientrare un problema nei limiti delle risorse disponibili: rendere più grossolana la mesh, tagliare il modello lungo un piano di simmetria che in realtà non esiste, omogeneizzare un avvolgimento, eliminare uno schermo.

Sono tutte decisioni che compromettono l'accuratezza per ragioni di memoria, ma che non compaiono nel rapporto finale.

I prossimi passi e cosa non c'è dentro

Questo risultato non utilizza alcuna forma di machine learning.

Nessun modello surrogato, nessun modello a ordine ridotto, nessuna rete neurale addestrata su bobine simili.

Ogni risultato deriva dalla soluzione delle equazioni di Maxwell per la geometria effettivamente analizzata. Questo aspetto ha un'importanza pratica: un modello surrogato è accurato all'interno dello spazio su cui è stato addestrato, ma può fornire risultati errati senza alcun avvertimento quando se ne esce.

E i progetti che vale maggiormente la pena simulare sono proprio quelli che nessuno ha ancora realizzato .Il passaggio da VINCO a Kaiba non è stato ottenuto tramite profiling, vettorizzazione o hardware più potente. E nemmeno il passaggio da due minuti a uno.In entrambi i casi è stato necessario modificare la matematica.

La prossima evoluzione di questo tipo è già stata formulata sulla carta, ma non è ancora stata implementata nel codice.

Il nostro obiettivo è arrivare a trenta secondi sullo stesso laptop. E potrete verificare se manterremo la promessa.

Condizioni del benchmark e riferimenti

- Problema. Problema di correnti parassite nel dominio della frequenza, conduttori lineari e isotropi nello spazio libero, con effetti pelle e di prossimità risolti. Un milione di elementi conduttori, soltanto rame, senza discretizzazione dell'aria. Frequenza di 1 MHz.

- Hardware e risultato. Laptop con 16 GB di RAM, senza cluster né GPU. Circa un minuto, includendo preparazione e soluzione del problema, con circa 4 GB di memoria utilizzando Kaiba v2 e circa 8 GB con Kaiba v1.

- Scalabilità. Tempo e memoria crescono linearmente con il numero di elementi conduttori, come verificato fino a dieci milioni di elementi. Costo computazionale sostanzialmente indipendente dalla frequenza nell'intervallo di validità dell'approssimazione magnetoquasistatica.

- Generazione precedente. VINCO, 2022, con un tempo stimato di circa tre ore per questa classe di geometrie. I risultati pubblicati riguardano benchmark più semplici: 1.030.656 tetraedri di una sfera piena risolti in 1.220 secondi utilizzando 13,5 GB su un laptop della stessa classe e in 649 secondi su un server a 32 core.

- Tecniche non utilizzate. Machine learning, modelli surrogati, riduzione dell'ordine del modello, riduzione per simmetria, semplificazioni geometriche.Pubblichiamo i problemi, la fisica e le condizioni dei benchmark. Non pubblichiamo il solutore.

Per la generazione precedente a Kaiba, la documentazione scientifica è disponibile pubblicamente:

• M. Passarotto, S. Pitassi, R. Specogna, "Foundations of volume integral methods for eddy current problems", Computer Methods in Applied Mechanics and Engineering, vol. 392, 114626, 2022.

• A. Vacalebre, S. Pitassi, R. Specogna, "Low-rank compression techniques in integral methods for eddy currents problems", Computer Physics Communications, vol. 289, 108756, 2023.

• D. Voltolina, R. Torchio, P. Bettini, R. Specogna, P. Alotto, "Optimized cycle basis in volume integral formulations for large scale eddy-current problems", Computer Physics Communications, vol. 265, 108004, 2021.

Kaiba è il motore di calcolo alla base di entrambe le nostre piattaforme: IPSMagic, per la progettazione, ottimizzazione e validazione di sensori induttivi di posizione, e MAGMagic, per il calcolo delle perdite e dei parametri parassiti nei componenti magnetici planari e nei layout dei circuiti di potenza.

Entrambe le piattaforme sono concesse in licenza a importanti produttori di semiconduttori e sensori.

Invito all'azione

Metteteci alla prova con un problema che non riuscite a risolvere

CTA: Inviateci una geometria che il vostro software attuale non riesce a discretizzare. Se avete un modello che il vostro software attuale non riesce a discretizzare, che supera la memoria disponibile o la cui simulazione non termina in tempi accettabili, è proprio il tipo di problema che ci interessa affrontare.

Inviateci la geometria e l'intervallo di frequenze: eseguiremo la simulazione e vi mostreremo il risultato, le condizioni di calcolo e il tempo impiegato. 

E se il vostro attuale processo di simulazione gestisce già bene quel problema, ve lo diremo altrettanto chiaramente.

© 2026 EMC Gems |
P.IVA/VAT IT03026280309 |
REA UD – 359523 |
Codice SDI USAL8PV |
Cap. Soc. € 10.000,00 i.v.